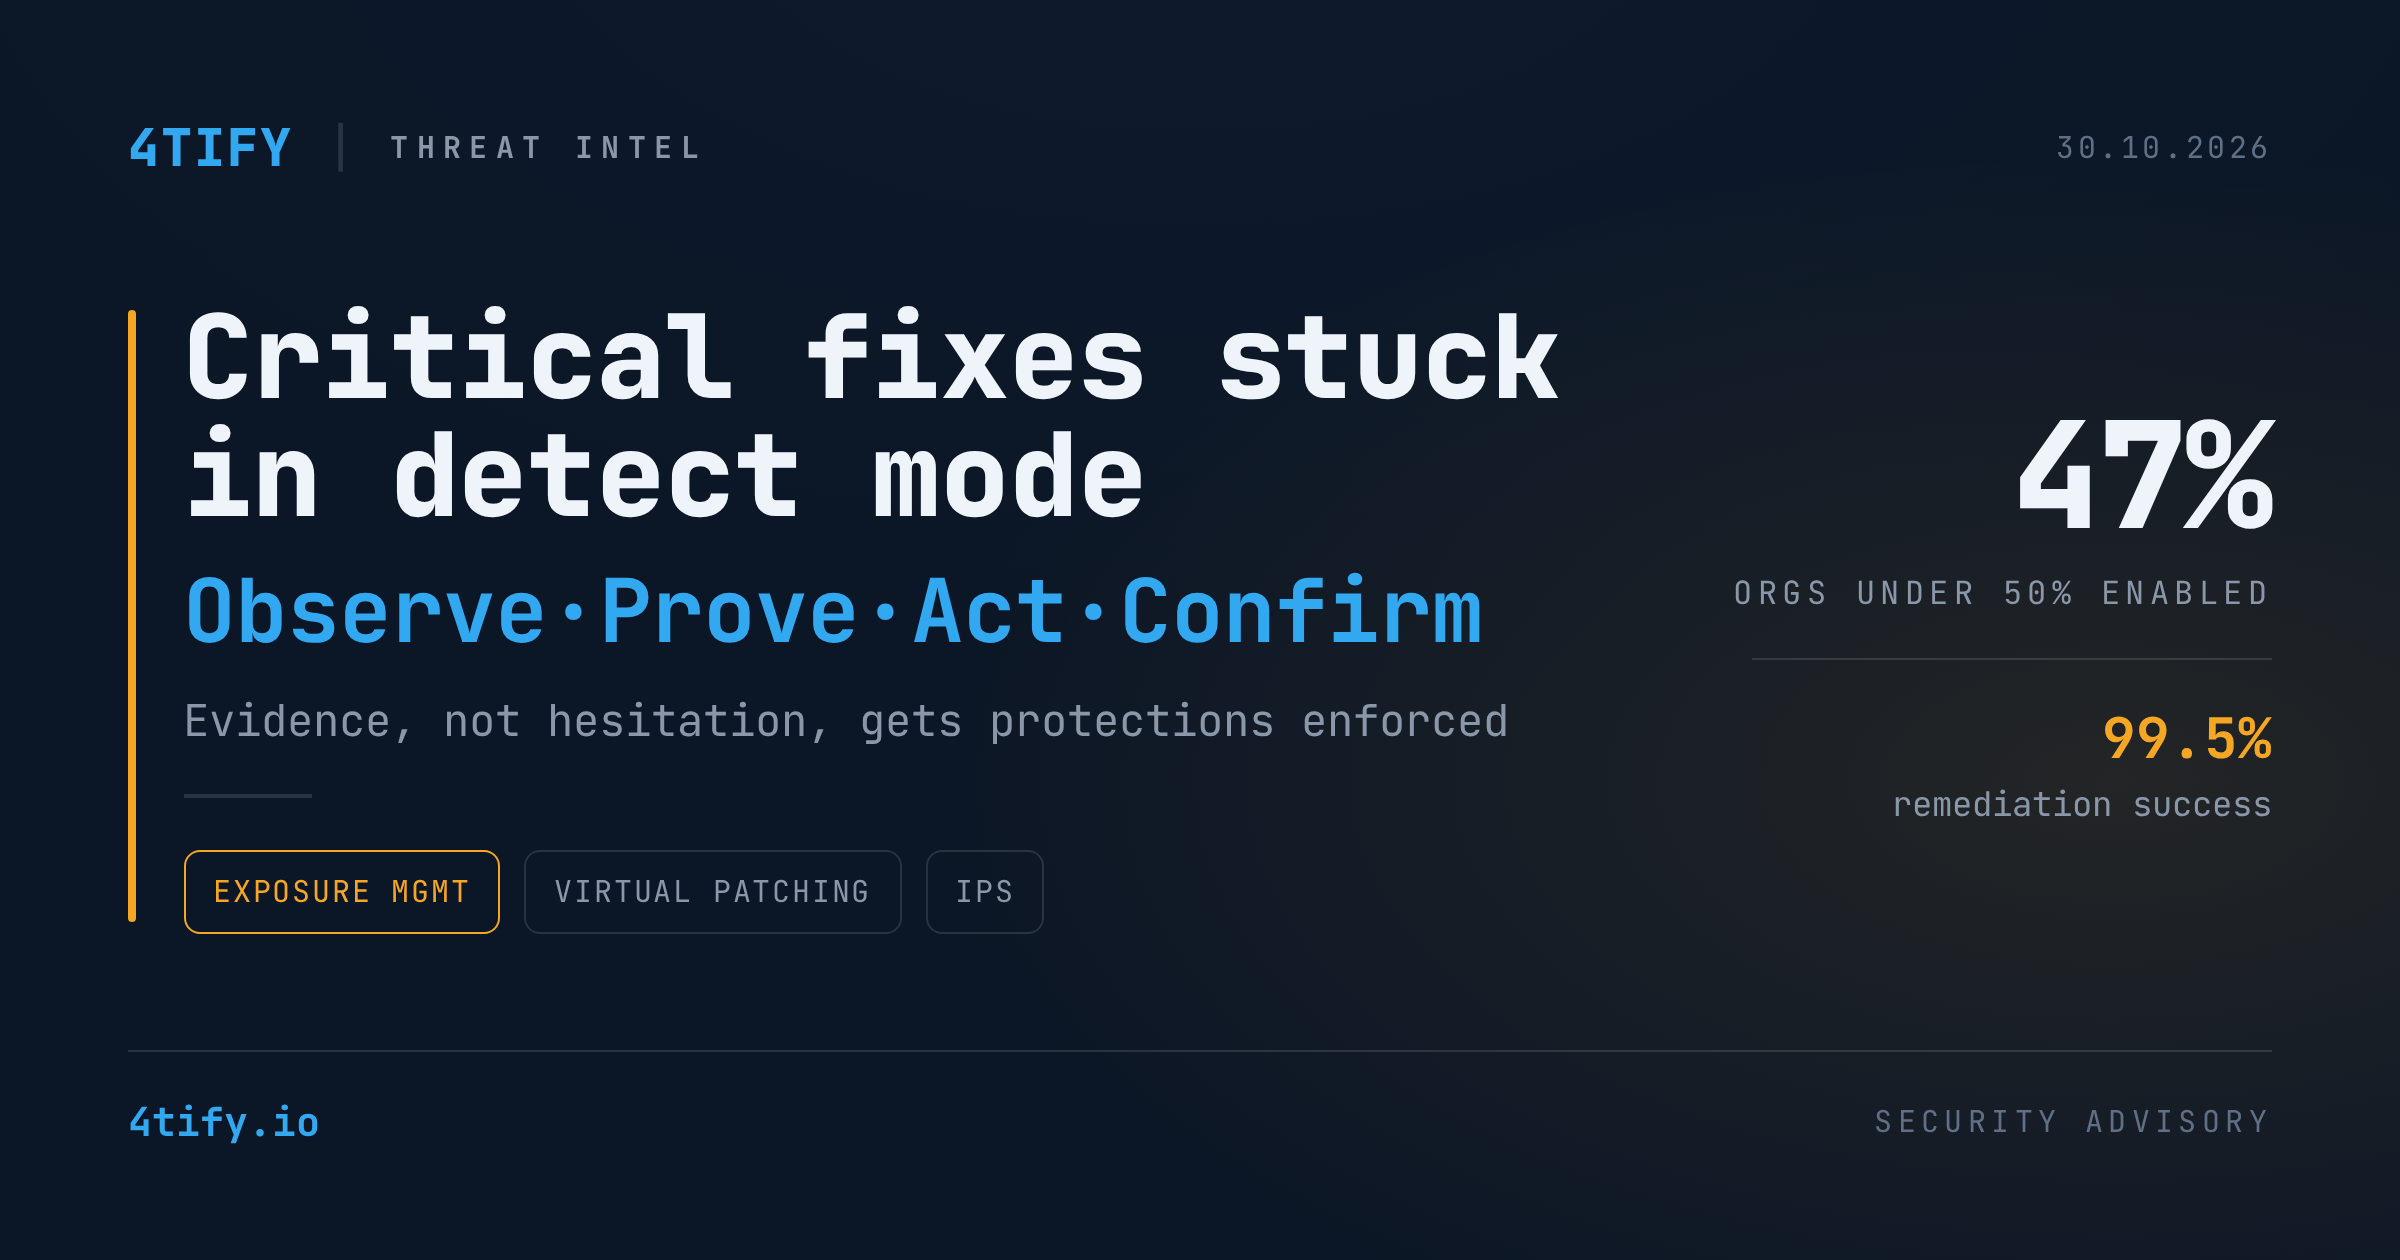
Correções críticas presas em modo de deteção? Um ciclo de quatro passos leva-as a produção
Chega um alerta crítico, a correção já é conhecida e, mesmo assim, o ticket fica na fila durante dias. Raramente é a equipa de segurança que trava. É o lado das operações a pedir provas de que a alteração não vai derrubar algo de que o negócio depende.
O problema: proteção que se tem mas não se aplica
A maioria das organizações já possui mais proteção do que aquela que usa. As assinaturas de prevenção de intrusões (IPS) estão desativadas ou apenas em modo de deteção, as políticas de hardening dos endpoints esperam por uma janela de alteração e as linhas de base dos sistemas operativos vão derivando enquanto as equipas pesam falsos positivos, capacidade de inspeção e continuidade do negócio. Numa medição feita sobre um conjunto alargado de ambientes corporativos, quase metade das organizações tinha ativado menos de 50 por cento das proteções que já tinha disponíveis.
A hesitação é razoável. Uma regra IPS pode bloquear tráfego legítimo. Uma alteração na firewall pode interromper um serviço. Uma política de endpoint pode partir precisamente a aplicação em que ninguém se atreve a tocar. Sem evidência, "deixa em deteção" é sempre a resposta segura para hoje. E a política deriva: uma configuração afinada para as ameaças e o tráfego da primeira semana fica muito diferente após cinco anos de novas aplicações, novos segmentos e exceções que nunca expiraram, até que ninguém na equipa se lembra de porque é que uma regra existe.
O ciclo Observar, Provar, Agir, Confirmar
A remediação segura substitui essa hesitação por evidência, levada ao longo de quatro etapas, com um ponto de revisão onde a organização o exigir.
- Observar. Parte dos dados que a pilha de segurança e de TI já produz: resultados de vulnerabilidades, tráfego IPS, utilização dos equipamentos, estado das políticas de endpoint e instantâneos de configuração. Em conjunto, mostram o contexto em redor da alteração proposta.
- Provar. Valida a alteração da forma adequada a cada tecnologia. Corre a assinatura IPS em modo de deteção sobre tráfego de produção para medir falsos positivos e carga antes de a passar a prevenção. Aplica uma alteração de hardening do sistema operativo a um grupo-piloto e volta a verificar cada host depois. Compara as definições dos endpoints com a linha de base de hardening do próprio fabricante.
- Agir. Após revisão e aprovação, empurra a alteração através do sistema que já detém esse controlo: o servidor de gestão de segurança para o IPS, a infraestrutura existente de gestão de patches para o hardening, a API do fabricante para as definições de endpoint suportadas. Sem ferramentas novas, apenas as tecnologias já implementadas.
- Confirmar. Verifica que a proteção está realmente ativa. Uma instalação de política bem-sucedida prova que a regra IPS chegou à aplicação. Uma verificação no host prova que a alteração de hardening se manteve. Os registos de execução mostram quem executou o quê, quando, contra que exposição, e que ações falharam ou continuam pendentes.
A decisão passa a ser específica do teu ambiente. A segurança explica a proteção que espera. Os responsáveis pela infraestrutura e pelas aplicações avaliam o efeito nos sistemas que gerem. Ambos os lados decidem em conjunto, com factos e não com medo.
Porque é que importa
Aplicar o patch corrige a vulnerabilidade de fundo, mas os testes, a coordenação e os calendários de implementação podem deixar uma janela de dias ou semanas até o patch chegar a produção. Uma assinatura IPS existente ou um patch virtual pode fechar o caminho de exploração relevante durante essa janela, desde que alguém saiba que existe e se está inativa, em modo de deteção ou já aplicada. Correlacionar os dados de vulnerabilidades com a cobertura dos controlos responde a essa pergunta e divide o atraso em duas filas claras: proteções candidatas a validação e ativação, e exposições sem controlo compensatório que precisam de patch urgente ou de outra ação.
Os resultados medidos sustentam o método. Nas organizações observadas, as ações de remediação registaram uma taxa de sucesso de 99,5 por cento. Num único mês, as proteções aplicadas desta forma bloquearam depois mais de 700 milhões de ataques, dos quais 21 milhões foram travados nas primeiras 24 horas após a alteração.
Uma ressalva deve constar em todos os registos de remediação: um controlo compensatório provisório não é uma correção permanente. Um caminho de exploração bloqueado reduz a exposição, mas a vulnerabilidade continua lá e continua a precisar de acompanhamento.
O que fazer
- Faz o inventário das proteções que já possuis e classifica cada uma como desligada, apenas deteção ou aplicada. A lacuna costuma ser maior do que se espera.
- Liga as vulnerabilidades abertas aos controlos que as podem cobrir, para que cada resultado crítico tenha ou um controlo compensatório ativo ou um prazo explícito de patch.
- Prova antes de aplicar: medição em modo de deteção para os controlos de rede, grupos-piloto para o hardening, comparação com a linha de base para os endpoints.
- Mantém a aprovação e a execução no mesmo fluxo de trabalho, com registo do utilizador, da data e hora e da exposição afetada.
- Trata "confirmado" como evidência, não como um estado do ticket. Mede o que o controlo bloqueou depois de aplicado.
- Regista as proteções provisórias separadamente das correções permanentes e mantém a tarefa de patch aberta até estar concluída.
É também aqui que a análise regular de vulnerabilidades ganha o seu lugar no ciclo. Uma análise independente antes e depois da alteração mostra se a exposição foi mesmo fechada, e não apenas se um ticket foi marcado como resolvido. A nossa equipa disponibiliza este tipo de análise como serviço contínuo, para que o passo de confirmação nunca dependa de alguém se lembrar de verificar.